


Web Scraper API
Fetch real-time data from 100+ websites,No development or maintenance required.
SCRAPING SOLUTIONS
Get accurate and in real-time results sourced from Google, Bing, and more.
With 120+ prebuilt and custom scrapers ready for any use case.
No blocks, no CAPTCHAs—unlock websites seamlessly at scale.
Execute scripts in stealth browsers with full rendering and automation
PROXY INFRASTRUCTURE
Over 100 million real residential IPs from genuine users across 190+ countries.
Reliable mobile data extraction, powered by real 4G/5G mobile IPs.
For time-sensitive tasks, utilize residential IPs with unlimited bandwidth.
Fast and cost-efficient IPs optimized for large-scale scraping.
SCRAPING SOLUTIONS
PROXY INFRASTRUCTURE
DATA FEEDS
Full details on all features, parameters, and integrations, with code samples in every major language.
LEARNING HUB
ALL LOCATIONS Proxy Locations
TOOLS
RESELLER
Get up to 50%
Contact sales:partner@thordata.com
Products $/GB
Fetch real-time data from 100+ websites,No development or maintenance required.
Get real-time results from search engines. Only pay for successful responses.
Execute scripts in stealth browsers with full rendering and automation.
Bid farewell to CAPTCHAs and anti-scraping, scrape public sites effortlessly.
Dataset Marketplace Pre-collected data from 100+ domains.
Over 100 million real residential IPs from genuine users across 190+ countries.
Reliable mobile data extraction, powered by real 4G/5G mobile IPs.
For time-sensitive tasks, utilize residential IPs with unlimited bandwidth.
Fast and cost-efficient IPs optimized for large-scale scraping.

Data for AI $/GB
Pricing $0/GB
Docs $/GB
Full details on all features, parameters, and integrations, with code samples in every major language.
Resource $/GB
EN $/GB
产品 $/GB
AI数据 $/GB
定价 $0/GB
产品文档 $/GB
资源 $/GB
简体中文 $/GB
社媒資料的採購邏輯已經翻轉。以前是「先爬再說,被擋再換 IP」;現在是 Reddit 對 AI 公司提起訴訟、平台授權協議動輒數千萬美元、企業買家在簽約前第一句話就問「你的訓練資料有授權嗎」。這份風險報告寫給正在為 LLM 尋找 X/Reddit 語料的團隊:爬取的法律暴露、持牌採購的市場現況,以及採購前該問供應商的五個問題。
三件事改變了社媒資料的採購決策:
一、訴訟成真。 內容平台開始對未經授權拿資料訓練模型的行為採取法律行動——Reddit 與 AI 公司的訴訟是地標案例。對訓練資料團隊而言,這不再是「條款灰色地帶」,而是「明天出現在被告欄」的具體風險。
二、買家在意。 企業採購 AI 模型時,訓練資料來源已是標準盡調問題。你的模型用什麼語料訓練、授權範圍是否涵蓋商用——回答不出來,合約就停在這裡。「公開網路上找的」在 2023 年是尷尬,在 2026 年是終止談判的理由。
三、持牌庫存出現。 過去想買 X/Twitter 資料只能靠平台官方的授權協議(價格是巨頭級的);現在,獨立資料商開始持有明確授權的社媒語料庫存——買家側第一次有了「爬取」與「巨頭協議」之外的第三條路。
| 路徑 | 法律姿態 | 成本形態 | 適合誰 |
|---|---|---|---|
| 自行爬取 | 暴露於平台條款與訴訟風險 | 工程成本高、帳號成本持續 | 沒有人——這是 2023 年的答案 |
| 平台官方授權 | 最穩 | 巨頭級定價,中小團隊不可及 | 有專屬商務關係的大廠 |
| 持牌資料商採購 | 授權隨紀錄交付 | 按筆計價,試點可負擔 | 絕大多數模型與產品團隊 |
第三條路就是這份報告的重點。以 Thordata 的目錄為例:X/Twitter 貼文資料庫存約 10 億則,以授權語料的形式出售——不是「我們幫你抓」,而是「已採集、已結構化、授權範圍寫明可用於模型訓練」的現貨;Reddit 貼文資料集同列目錄,交付格式為 JSON/CSV/Parquet,支援樣例先行(sample-first)——先看欄位、再談規模。目錄級定價約從每 1,000 筆 $0.25 起,社媒垂直語料按範圍報價。
這個市場上,Bright Data 經營的是另一種正當模式:一個 700 多種現成資料集的市集,每個垂直品類獨立落地頁,價格透明(例如電商資料 $250/10 萬條的明碼標價),加上大型客製採集服務。對需要「一個市集裡比價多品類」的買家,那是一條成熟的路線。
Thordata 的差異化在庫存結構:社媒與影片語料的量級(10 億則 X 貼文、200 億條評論、60 億支影片),以及持牌表述直接寫進紀錄結構——授權範圍、來源譜系逐筆隨行,法務審查有具體標的可看。兩種模式都成立;買家的選擇取決於你要的是市集廣度,還是特定語料的深度與授權明確性。對比維度建議對齊五把尺:授權範圍、更新頻率、垂類覆蓋、資料可攜性、定價模式——這也是業界買家評估資料商的通用框架。
「licensed twitter data provider」在搜尋時怎麼分辨真偽?
看兩件事:授權表述是否具體(誰授權、什麼範圍、可否商用訓練),以及是否敢讓你審計樣例。真正的持牌庫存不怕問題;把「合規」當形容詞而不是名詞的供應商,才是風險。
已經爬了一部分,現在怎麼辦?
常見情境。務實路徑:爬取資料隔離不再用於訓練、以持牌語料重建訓練集、保留採購紀錄作為盡調證據。法務團隊要的是「何時停止、用什麼替代」的故事,不是完美無瑕的過去。
預算有限的團隊從哪個量級開始?
按筆計價的意義就在這:先授權一個聚焦的分片(例如特定主題、特定年份的 X 語料),用現有管線驗證訓練增益,再擴大。試點是幾百美元的決策,不是季度專案。
除了訓練,持牌社媒語料還有什麼用途?
輿情與趨勢情報:產品上市後的市場反應、危機監測、竊聽使用者真實語彙。同一份採購、兩種價值——而且輿情側還需要搜尋層的視角:透過 SERP 監控解決方案(約每 1,000 次結構化回應 $0.70)追蹤品牌詞與產品詞的搜尋動向,把「社群在說什麼」與「市場在搜什麼」放進同一張圖。
搜尋側資料對採購決策本身有幫助嗎?
有——需求驗證。哪個市場、哪類產品在你的目標語料裡討論度最高,持續 SERP 資料爬取的查詢資料會先給你答案,讓授權範圍跟著證據走而不是跟著直覺走。而且搜尋能見度本身也是產品問題:你的模型產品頁在 AI 答案層有沒有被引用,同樣能用排名監控量出來——持牌資料訓練的模型,值得被找到。
一句話結論?
社媒語料的採購決策,已經從工程問題變成治理問題:爬取的每一 GB 都在累積沒人入帳的法律負債,而持牌庫存的價格已經低到「省下的授權費」不再是理由。買,不要爬——這不是道德建議,是 2026 年的資產負債表常識。
 Looking for
Top-Tier Residential Proxies?您在寻找顶级高质量的住宅代理吗?
一張網紅報價單,值多少錢?把直覺換成算式給老闆看
網紅行銷最大的成本不是報價,是「憑感覺成交」——粉絲數可以買 ...
Xyla Huxley
2026-10-15
Legal Said No. Data Said Yes. The 90-Minute Meeting That Fixed Both.
The slowest part of buying tra ...
Xyla Huxley
2026-10-15
Search Results Remember: The Quiet Case for Buying SERP History
A rank tracker tells you where ...
Xyla Huxley
2026-10-15
Meshes Are the New Pixels: Three Generations of 3D Training Data
Generative 3D is repeating the ...
Xyla Huxley
2026-10-15
Read Any Language, Even in Bad Handwriting: An OCR Data Quotation, Teardown-Style
Every OCR project's roadmap di ...
Xyla Huxley
2026-10-15
Your Customers Already Wrote the Spec Sheet: Mining Amazon Reviews at Corpus Scale
Every product question a consu ...
Xyla Huxley
2026-10-15
開店之前,先買一張地圖:展店選址的資料採購清單
連鎖品牌展店選址的成敗,一半在租金談判之前就決定了——商圈密 ...
Xyla Huxley
2026-10-13

The Pricing Team’s First Data Vendor: A One-Page Due Diligence
Pricing teams are expert buyers of software and naive b […]
Unknown
2026-10-13
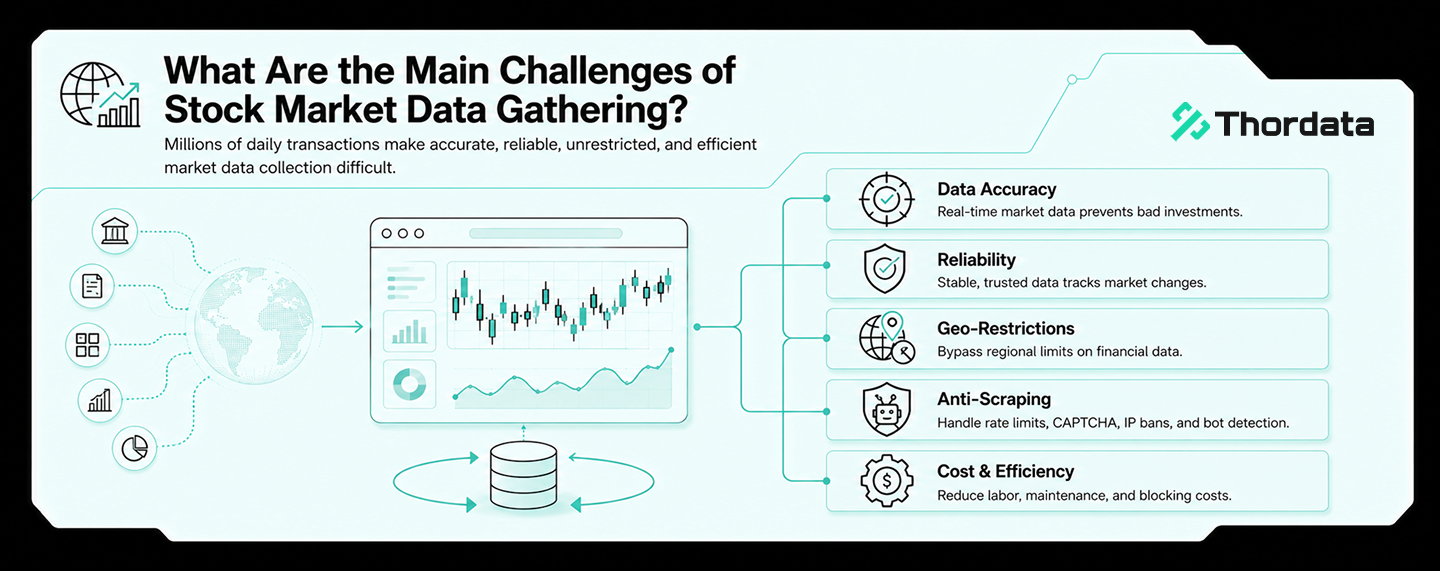
Ten Weeks Inside a Trend Desk: Notes From the Team That Stopped Scraping TikTok
A consumer-insights team runni ...
Xyla Huxley
2026-10-13