


Web Scraper API
Fetch real-time data from 100+ websites,No development or maintenance required.
SCRAPING SOLUTIONS
Get accurate and in real-time results sourced from Google, Bing, and more.
With 120+ prebuilt and custom scrapers ready for any use case.
No blocks, no CAPTCHAs—unlock websites seamlessly at scale.
Execute scripts in stealth browsers with full rendering and automation
PROXY INFRASTRUCTURE
Over 100 million real residential IPs from genuine users across 190+ countries.
Reliable mobile data extraction, powered by real 4G/5G mobile IPs.
For time-sensitive tasks, utilize residential IPs with unlimited bandwidth.
Fast and cost-efficient IPs optimized for large-scale scraping.
SCRAPING SOLUTIONS
PROXY INFRASTRUCTURE
DATA FEEDS
Full details on all features, parameters, and integrations, with code samples in every major language.
LEARNING HUB
ALL LOCATIONS Proxy Locations
TOOLS
RESELLER
Get up to 50%
Contact sales:partner@thordata.com
Products $/GB
Fetch real-time data from 100+ websites,No development or maintenance required.
Get real-time results from search engines. Only pay for successful responses.
Execute scripts in stealth browsers with full rendering and automation.
Bid farewell to CAPTCHAs and anti-scraping, scrape public sites effortlessly.
Dataset Marketplace Pre-collected data from 100+ domains.
Over 100 million real residential IPs from genuine users across 190+ countries.
Reliable mobile data extraction, powered by real 4G/5G mobile IPs.
For time-sensitive tasks, utilize residential IPs with unlimited bandwidth.
Fast and cost-efficient IPs optimized for large-scale scraping.

Data for AI $/GB
Pricing $0/GB
Docs $/GB
Full details on all features, parameters, and integrations, with code samples in every major language.
Resource $/GB
EN $/GB
产品 $/GB
AI数据 $/GB
定价 $0/GB
产品文档 $/GB
资源 $/GB
简体中文 $/GB
从零把 Thordata SERP API 接进 LlamaIndex:安装 tool spec、读取它实时拉取的引擎 schema、跑一次真实搜索,最后让 FunctionAgent 用模型训练时还不存在的数据回答问题。
LLM 只知道自己训练时见过的内容。问它这周的搜索结果,它要么拒答,要么更糟——一本正经地编一个答案。解决办法不是换更大的模型,而是给模型一个工具:让它去取当下的页面,并拿回可以引用的结构化数据。
本教程就把这件事从头到尾做一遍,用的正是 Thordata 提供的 LlamaIndex SERP 工具。范围刻意收窄:一个工具集、三个工具、一个 Agent。没有向量库,也没有数据摄入管线——这里只讲”搜索”这一半,但把它接到 Agent 能用的程度。
读完之后你会掌握:
llama-index-tools-thordata-serp 并加载 ThordataSerpToolSpecFunctionAgent 把工具包起来目录
LlamaIndex 是用于构建大模型应用的开源 Python 框架,GitHub 上约 5.2 万 star,MIT 许可。本教程编写时使用的版本是 llama-index-core 0.14.25。
这篇教程只需要它三块能力:
OpenAI、OpenAILike、Anthropic 等),把各家不同的对话与 function calling 接口统一起来。ToolSpec 是 LlamaIndex 对”一组相关工具”的打包约定。Thordata 的集成正是这个形态:一个类 ThordataSerpToolSpec,对外暴露三个工具,可以直接丢给任何接受 tools 的 Agent。
大模型有三个特性,让搜索工具从”锦上添花”变成”必需”:
常见的替代方案——手工把搜索结果贴进 prompt——在 Agent 场景里行不通:是 Agent 自己决定搜什么、什么时候搜,所以搜索必须是”可被调用”的工具。
抓一次搜索结果页看上去是十行脚本,实际维护起来像一份长期合同。你需要自己承担:验证码与反爬对抗、代理轮换、按国家/语言的本地化结果、随时改版的 HTML,以及每个引擎一套解析。解析是最容易被低估的部分——有价值的信息很少只在一个列表里:新闻结果、answer box、本地商家卡片、相关问题分别落在不同位置,且各引擎不同。
Thordata 的 SERP API 就是把这部分接过去:一次 HTTPS 请求返回目标引擎解析好的 JSON,代理与地理定位都已包含在内。
就算接口再好,Agent 还需要一样原始 API 不会提供的东西:运行时可以发现的参数集合。Agent 自己挑参数,猜错参数名轻则报 400,重则悄悄搜错东西。
LlamaIndex 这个包用 Thordata 为自家 playground 发布的 schema 解决了这一点。请求发出之前,工具会用所选引擎的线上 schema 校验参数,把该引擎没有声明的字段直接丢掉。这就是”调用一个 API”和”让 Agent 调用一个 API”的区别:这个工具可以放心交给一个从没读过文档的模型。
包名 llama-index-tools-thordata-serp 0.1.0,导入路径 llama_index.tools.thordata_serp。要求 Python 3.10 及以上,会一并安装 llama-index-core(>=0.13.0, <0.15)、pydantic 和 requests。
一个类 ThordataSerpToolSpec,对外只有三个工具:
| 工具 | 作用 | 为什么 Agent 需要它 |
|---|---|---|
list_engines() | 返回 schema 版本、默认引擎、schema 来源,以及每个引擎的简要记录(key、name、query field)。 | Agent 能自己发现 google_news、google_maps 的存在,而不是猜一个写死的引擎名。 |
get_engine_schema(engine) | 返回某个引擎完整的参数分组与字段,包括类型和可选值。 | Agent 能查到某类查询该用哪个参数:多数引擎是 q,机票是 departure_id,Lens 是 url。 |
search(engine, query, params, response_format, response_mode) | 按 schema 校验参数、发起请求,并把解析结果放进统一的信封返回。 | 真正的搜索入口;模型能控制的一切都走这一个签名。 |
所有工具返回的都是 JSON 字符串,不是 Python 对象,读取字段前先 json.loads。成功与失败共用同一种结构,因此错误处理不依赖异常:
{"ok": true, "status": 200, "engine": "google", "data": { ... }}

{"ok": false, "error": {"type": "SerpApiError", "status_code": 401, "message": "..."}}
动手写胶水代码之前,还有两个行为值得先知道:
schema_source: "remote",五分钟内的后续调用返回 "cache"。如果在加载到任何 schema 之前远端就不可用,包会退回 wheel 内置的快照,并报告 "snapshot"。只有 list_engines 和 get_engine_schema 带这个字段,search 只返回 ok、status、engine、data。工具本身不读环境变量。 API Token 必须显式传入(ThordataSerpToolSpec(api_key=...),api_key 是包自己的参数名,接收的就是 Thordata API Token)。这是有意为之——配置留在你的应用里,而不是藏进依赖包内部——所以下面每个示例都是先读环境变量,再交给工具。
>=3.10,<4.0,本教程在 3.12 上实测。所有代码放在一个目录里,并配独立虚拟环境:
mkdir thordata-llama-agent
cd thordata-llama-agent
python -m venv .venv
激活命令按终端区分:
# Windows (PowerShell)
.venv\Scripts\Activate.ps1

# Windows (cmd.exe)
.venv\Scripts\activate.bat

# macOS / Linux
source .venv/bin/activate
然后安装工具包,以及下面脚本用来读取 .env 的 python-dotenv。工具包会一并带上 llama-index-core、pydantic 和 requests,所以前面几步装这一条就够:
python -m pip install llama-index-tools-thordata-serp python-dotenv.env涉及两个凭据:Thordata 的 API Token 和 LLM 的 API Token。两个都写进代码同级的 .env,不要写进源码:
# Thordata SERP Token,来自控制台
# (SERP API -> API Token,也可从 API Playground -> Token 进入)
THORDATA_SERP_API_TOKEN=your-thordata-serp-token

# 任意 OpenAI 兼容接口。下面的值是本地 Ollama;
# 用云端提供商时改成 e.g. https://api.openai.com/v1 并换成自己的模型
LLM_BASE_URL=http://127.0.0.1:11434/v1
LLM_MODEL=qwen3:1.7b
LLM_API_TOKEN=ollama

# 可选。仅当 LlamaIndex 查不到该模型的上下文长度时才需要。
# LLM_CONTEXT_WINDOW=32768
第一件事就是把 .env 加进 .gitignore。提交上去的 Token 等于作废的 Token。
登录 Thordata 控制台,复制你的 SERP Token——官方文档给了两个入口:SERP API → API Token 与 API Playground → Token。如果还没生成过就先生成一个;免费试用额度也在同一处。
控制台登录页,新账号也可以在这一页注册;登录后,文档给出两个 Token 入口:SERP API → API Token 与 API Playground → Token,下面那张图就是该 Token 认证的原始请求。
这个 Token 认证的就是一次普通的 HTTPS 调用。写 Python 之前先看一眼原始请求很有必要,因为刚装的包正是对这次调用的封装——官方文档的首个请求示例就是最好的参照:
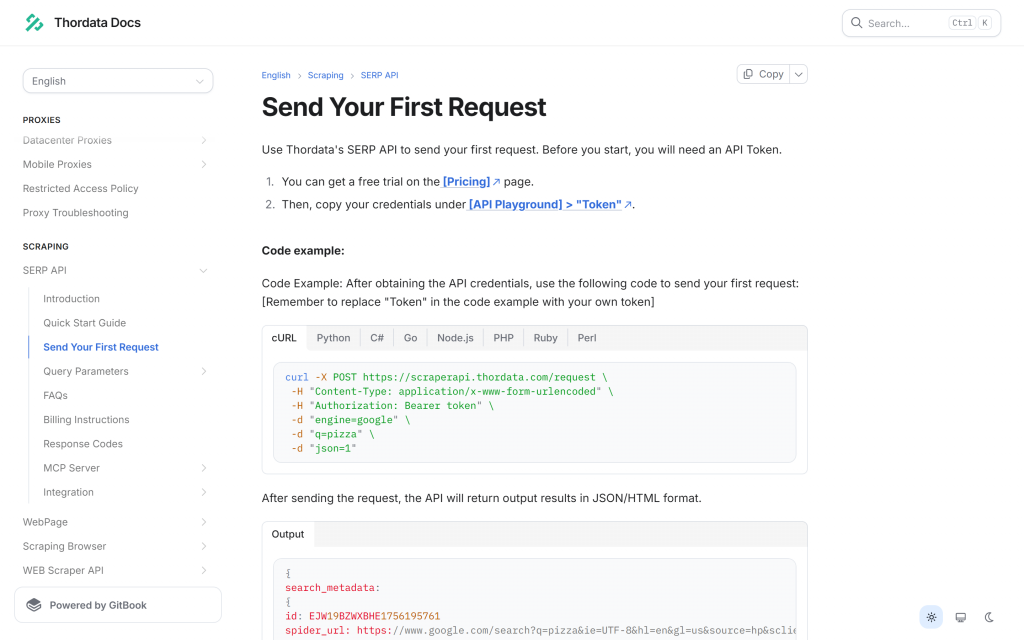
工具替你发出的原始请求:POST 到 scraperapi.thordata.com/request,带 Bearer Token、engine、查询词和 json=1。
底层实现上,工具会以表单编码(engine、该引擎的查询字段、json)POST 到 https://scraperapi.thordata.com/request,并从 https://api.thordata.com/serp/playground/schema?lang=en 拉取引擎 schema。这两个地址都不需要你配置,但如果你要走自己的代理,构造参数里可以覆盖。
把下面内容保存为 tool_demo.py。它不涉及 Agent 和 LLM,只调用这个包——确认 Token 可用、顺便亲眼看到 schema 的最快方式:
"""Call the Thordata SERP tool directly - no agent, no LLM involved."""

import json
import os
import textwrap

from dotenv import load_dotenv
from llama_index.tools.thordata_serp import ThordataSerpToolSpec

load_dotenv()

tool_spec = ThordataSerpToolSpec(api_key=os.environ["THORDATA_SERP_API_TOKEN"])

# 1. Which engines can this tool reach?
engines = json.loads(tool_spec.list_engines())
keys = [engine["key"] for engine in engines["engines"]]
print(f"1) Engines - schema v{engines['schema_version']} from {engines['schema_source']}")
print(f"   {len(keys)} engines, default is {engines['default_engine']}")
print(textwrap.fill(", ".join(keys[:10]), width=96, initial_indent="   ", subsequent_indent="   "))

# 2. What parameters does the google engine accept?
schema = json.loads(tool_spec.get_engine_schema("google"))
fields = [field["key"] for group in schema["engine"]["groups"] for field in group["fields"]]
print(f"\n2) The google engine accepts {len(fields)} parameters")
print(textwrap.fill(", ".join(fields), width=96, initial_indent="   ", subsequent_indent="   "))

# 3. Run a search and print the organic results.
result = json.loads(
    tool_spec.search(
        engine="google",
        query="best coffee grinders 2026",
        params={"num": 3, "gl": "us", "hl": "en"},
        response_mode="compact",
    )
)
if not result["ok"]:
    print(f"\n3) Search failed - {result['error']['type']}: {result['error']['message']}")
    raise SystemExit(1)
print(f"\n3) Search - ok={result['ok']} status={result['status']} engine={result['engine']}")
for item in result["data"]["organic"]:
    print(f"   {item['position']}. {item['title']}")
    print(f"      {item['link']}")
用 python tool_demo.py 运行。下面的输出里有两处值得停下来看:第一,schema 来自 remote,不是内置快照;第二,那串字段列表就是”我能传什么”的答案——Google 引擎有 num、gl、hl、tbs、safe、location 等二十多个参数,全部在请求发出前完成校验。搜索段还先判断了 ok 再读结果字段,所以 Token 无效或过期时只会打印一行可读的错误,而不是 KeyError——这也是后文”在一处处理失败”里再次用到的写法。
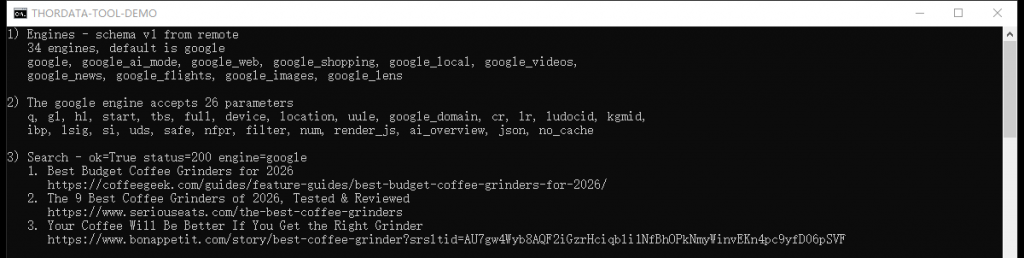
一次真实运行:34 个引擎、Google 引擎 26 个参数、实时自然结果——只有一个 Python 文件,没有 LLM。
引擎列表不是装饰。按提供方分组,当前线上 schema 提供 26 个 Google 引擎(Search、AI Mode、Web、Shopping、Local、Videos、News、Flights、Images、Lens、Trends、Hotels、Play、Jobs、Scholar、Maps、Finance、Patents 及其变体)、6 个 Bing 引擎(Search、Images、Videos、News、Maps、Shopping),以及 Yandex Search 和 DuckDuckGo Search。因为 schema 是运行时拉取的,这份列表可以在不发新版本的情况下增长。
把工具交给模型之前,值得先看清模型到底会看到什么。下面这段打印一条新闻结果,以及故意用错误 Token 时的信封:
import json
import os

from dotenv import load_dotenv
from llama_index.tools.thordata_serp import ThordataSerpToolSpec

load_dotenv()

tool_spec = ThordataSerpToolSpec(api_key=os.environ["THORDATA_SERP_API_TOKEN"])
raw = tool_spec.search(
    engine="google_news",
    query="semiconductor supply chain",
    response_mode="compact",
)
data = json.loads(raw)
if not data["ok"]:
    raise SystemExit(f"search failed: {data['error']}")
print("envelope keys:", list(data.keys()), "| ok:", data["ok"], "| status:", data["status"])

headline = data["data"]["news"][0]
fields = {key: headline[key] for key in ("title", "source", "date", "link")}
print(json.dumps(fields, indent=2, ensure_ascii=False))

invalid_spec = ThordataSerpToolSpec(api_key="00000000000000000000000000000000")
bad = json.loads(invalid_spec.search(engine="google", query="test"))
print("\nbad token ->", json.dumps(bad))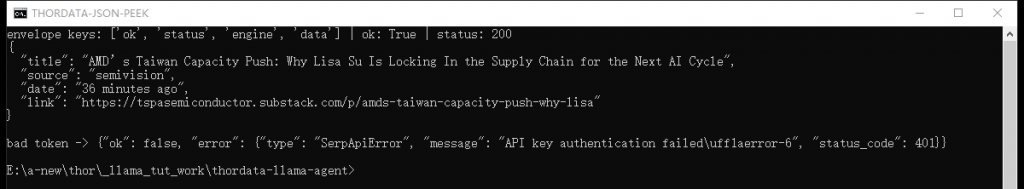
上:信封里的一条真实新闻结果。下:同一个信封结构承载被拒绝的 Token——401 以数据形式返回,而不是抛异常。
新闻结果带 title、link、source、date、snippet、image_url;Google 网页结果则是 data.organic 下的 position、title、link、description,页面上有时还会带 people_also_ask 和 related。其他引擎各有自己的键——Maps 是 places,Shopping 是 shopping,Bing 是 organic_results——所以 Agent 应该调用 get_engine_schema,而不是假定只有一种结构。
在 Agent 代码里用 response_mode="compact"。 它会在每一层嵌套里去掉 search_metadata、search_parameters、serpapi_pagination 和 request_metadata。排查请求时这些字段有用,进了模型要读的上下文窗口就是纯浪费。
response_format 建议保持默认值。 工具会把它作为 API 的 json 参数发出,并在本地做校验:可接受的取值是 "1"、"2"、"3",默认 "1"。这个集合与引擎 schema 对同一字段的定义并不一致——schema 里 1 = JSON、4 = Light JSON、3 = HTML、5 = Screenshot——所以 "4" 和 "5" 根本传不进去(会以校验错误落在信封里),而 "3" 会原样透传,尽管 schema 把它定义为 HTML。实测中 1、2、3 三种取值返回的是同一份解析后 JSON,所以对 Agent 来说默认值就是正确选择。
没有模型时 tool spec 依然是完整的,但 Agent 不是。安装一个 OpenAI 兼容客户端——它同样能对接任何说同一套 API 的服务,这也是本地模型和自建网关能在这里用起来的原因:
python -m pip install llama-index-llms-openai-like下面的 Agent 代码从 .env 读取三个值:LLM_BASE_URL、LLM_MODEL、LLM_API_TOKEN。把它们指向 OpenAI、本地 Ollama、vLLM,或任何暴露 OpenAI 兼容接口的服务都行,代码不用改。(如果你用的是 OpenAI 自家模型,llama-index-llms-openai 的 OpenAI 类也可以用;那个类会拿 OpenAI 的模型目录校验模型名,而这正是 OpenAILike 不做的一件事。)
FunctionAgent 是 LlamaIndex 的 function calling Agent:把工具 schema 交给模型,执行模型要求的调用,循环直到模型给出答案。这里的 system prompt 在做实事——它要求模型”先搜索再回答”并”引用用到的链接”,这正是让答案有依据的关键。把它包进 build_agent() 函数,REPL 就能在启动时构建一次 Agent:
"""A LlamaIndex agent that answers questions with live Thordata SERP data."""

import asyncio
import os

from dotenv import load_dotenv
from llama_index.core.agent.workflow import FunctionAgent, ToolCallResult
from llama_index.llms.openai_like import OpenAILike
from llama_index.tools.thordata_serp import ThordataSerpToolSpec

load_dotenv()

SYSTEM_PROMPT = (
    "You are a research assistant with a live web search tool. "
    "Always call the search tool before you answer, keep the answer under 120 words, "
    "and cite the result URLs you used."
)


def build_agent() -> FunctionAgent:
    """Wire the Thordata SERP tools and an OpenAI-compatible LLM into one agent."""
    tool_spec = ThordataSerpToolSpec(api_key=os.environ["THORDATA_SERP_API_TOKEN"])
    llm = OpenAILike(
        model=os.environ["LLM_MODEL"],
        api_base=os.environ["LLM_BASE_URL"],
        api_key=os.environ["LLM_API_TOKEN"],
        is_chat_model=True,
        is_function_calling_model=True,
        context_window=int(os.environ.get("LLM_CONTEXT_WINDOW", "32768")),
        timeout=300,
    )
    return FunctionAgent(
        tools=tool_spec.to_tool_list(),
        llm=llm,
        system_prompt=SYSTEM_PROMPT,
    )
这段代码里有三个细节很容易被忽略,每一个都能让你多花一小时:
to_tool_list() 才是把 ToolSpec 转成 Agent 接受的工具对象的方法;直接传 ToolSpec 不行。is_chat_model 和 is_function_calling_model 必须显式设为 True。这两个标记在构造请求时才被读取,而不是构造 Agent 时,所以配错了要到第一次 agent.run() 才暴露——而且两个标记的报错并不相同:缺 is_function_calling_model 报 “LLM must be a FunctionCallingLLM”;只设了它、is_chat_model 仍是默认值时,请求会打到 completions 端点,报的是 “AsyncCompletions.create() got an unexpected keyword argument ‘tools'”。context_window 同理必须声明——框架查不到未知模型名的上下文长度,而默认占位值对一页搜索结果来说远远不够。最后是一个提问循环,真正有用的部分是它会把每次工具调用实时打出来——用的是真实工具名和模型实际选的参数。没有它,慢回答看起来就像卡死;有了它,你能确认模型真的去搜索了,而像 list_engines() 这样的元数据调用也不会被误当成搜索:
async def ask(agent: FunctionAgent, question: str) -> str:
    """Run one turn and report every tool call while the agent works."""
    handler = agent.run(question)
    async for event in handler.stream_events():
        if isinstance(event, ToolCallResult):
            print(f"  [tool] {event.tool_name}({event.tool_kwargs})")
    return str(await handler)


async def main() -> None:
    agent = build_agent()
    print("Thordata SERP agent ready - ask a question, or type 'exit'.")
    while True:
        question = input("\nYou: ").strip()
        if question.lower() in {"exit", "quit"}:
            break
        if question:
            print(f"\nAgent: {await ask(agent, question)}")


if __name__ == "__main__":
    asyncio.run(main())
第 7 步和第 8 步合起来就是完整的 Agent——包括 import、Agent 和 REPL。把上面的代码块保存为第 1 步创建的项目里的 agent.py,然后运行:
python agent.py下面是一次真实会话。问题需要 2026 年的数据,模型自己选了一个查询词调用搜索工具一次,答案里引用的两个链接正是这次返回结果中的 URL:
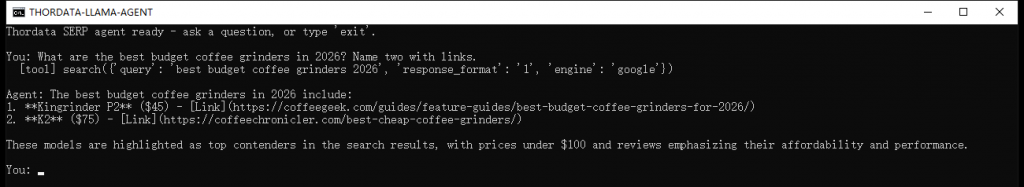
一次对正式服 SERP 接口的真实会话:一次工具调用,然后是一个引用该次返回链接的答案。
这张截图之所以可信而不只是”看着像”,靠的是两个可复现的检查,建议你用同样方式验证自己的问题。第一,[tool] 行给出的是模型真正调用的工具名和它选的参数——这次运行是 search,带查询词、引擎与响应格式——所以像 list_engines() 这样的元数据调用不会被误当成搜索。第二,答案引用的链接可以和该查询的原始返回逐条比对:这次运行里第 1 位是 coffeegeek.com、第 2 位是 coffeechronicler.com,与答案中的引用一致。
“有依据”取决于你的 prompt 和模型,而不是工具本身。 同一个问题再跑一次时,本地模型保留了正确的搜索和正确的第一位结果,却把第二条引用挂到了一个根本没出现在返回结果里的域名上——一个它自己编出来的、看起来很合理的 URL。工具返回的是干净数据,是模型给它加了戏。所以保持两个习惯:把工具调用打出来,并抽查答案里的 URL 是否真的出现在工具返回中。
Agent 本身和 Google 无关,引擎只是一个参数——同一个工具覆盖新闻、地图、购物,而且只要 Agent 拿得到 list_engines,它就能自己挑引擎:
news = tool_spec.search(engine="google_news", query="ai regulation", response_mode="compact")
places = tool_spec.search(engine="google_maps", query="coffee shops in seattle", params={"num": 3}, response_mode="compact")
prices = tool_spec.search(engine="google_shopping", query="espresso machine", params={"num": 3}, response_mode="compact")
papers = tool_spec.search(engine="google_scholar", query="retrieval augmented generation", params={"num": 3}, response_mode="compact")每个引擎返回自己的结果键——news、places、shopping、organic——所以如果你是在代码里消费而不是交给 Agent,最好维护一张映射表,而不是假定只有一种字段名。
schema 就是契约,其中三个 Google 参数几乎每次调用都值得写清楚:
num —— 返回多少条结果。十条原始 JSON 是很大的上下文;做摘要通常三条就够。gl —— 查询哪个国家的 Google。不同国家结果集不同,而模型无从推断你要哪一个。hl —— 界面语言。你传入但所选引擎没有声明的参数,会在请求发出前被丢弃,所以一个拼写错误会退化成默认搜索而不是报错。这在生产里很宽容,在调试时却很迷惑——如果某个参数看起来没生效,调用 get_engine_schema 对照字段列表检查拼写。
因为所有工具返回同一个信封,错误处理只需要一个分支——上游失败也一样,它们以 ok: false 加状态码返回:
result = json.loads(tool_spec.search(engine="google", query="coffee"))
if not result["ok"]:
    print(result["error"]["type"], result["error"].get("status_code"), result["error"]["message"])
在 Agent 里,同一个信封会交到模型手上,于是一次失败的搜索变成模型可以应对的情况——换个查询重试,或者告诉用户它没找到什么——而不是一个中断整个流程的异常。
schema_source。response_mode="compact" 加上较小的 num,比换更大的上下文窗口更省钱。把 LlamaIndex 和 Thordata 的 SERP API 配在一起,得到的 Agent 建立在两样你能掌控的东西之上:工具跑在你自己的进程里,答案在提问的那一刻实时取回。整个集成小到一次就能读完——三个工具加一个信封——而且每一部分都能替换:换引擎、换查询参数、换 LLM、换 system prompt,都不需要动其它环节。
同一套形状远不止能做 Google 网页结果。工具暴露了平台的全部引擎目录,所以只要换一个参数,就能从网页切到新闻、商品价格、论文、本地商户或搜索趋势;而由于 get_engine_schema 会把每个引擎接受什么告诉模型,这个选择可以由 Agent 自己来做。当你还需要在答案里带上自己的文档时,把这些结果喂进 LlamaIndex 索引就是框架的另一半,而上面的内容一行都不用改。
要用你自己的账号跑起来,先在 Thordata 控制台创建一个 API Token,并把 doc.thordata.com 打开备查参数——SERP API 那一节写明了每个引擎各自接受什么。上面的两个代码块已经自包含,准备运行时分别保存为 tool_demo.py 和 agent.py 即可;截图可用来对照自己的运行结果。
 Looking for
Top-Tier Residential Proxies?您在寻找顶级高质量的住宅代理吗?
一張網紅報價單,值多少錢?把直覺換成算式給老闆看
網紅行銷最大的成本不是報價,是「憑感覺成交」——粉絲數可以買 ...
Xyla Huxley
2026-10-15
Legal Said No. Data Said Yes. The 90-Minute Meeting That Fixed Both.
The slowest part of buying tra ...
Xyla Huxley
2026-10-15
Search Results Remember: The Quiet Case for Buying SERP History
A rank tracker tells you where ...
Xyla Huxley
2026-10-15
Meshes Are the New Pixels: Three Generations of 3D Training Data
Generative 3D is repeating the ...
Xyla Huxley
2026-10-15
Read Any Language, Even in Bad Handwriting: An OCR Data Quotation, Teardown-Style
Every OCR project's roadmap di ...
Xyla Huxley
2026-10-15
Your Customers Already Wrote the Spec Sheet: Mining Amazon Reviews at Corpus Scale
Every product question a consu ...
Xyla Huxley
2026-10-15
開店之前,先買一張地圖:展店選址的資料採購清單
連鎖品牌展店選址的成敗,一半在租金談判之前就決定了——商圈密 ...
Xyla Huxley
2026-10-13

The Pricing Team’s First Data Vendor: A One-Page Due Diligence
Pricing teams are expert buyers of software and naive b […]
Unknown
2026-10-13
Ten Weeks Inside a Trend Desk: Notes From the Team That Stopped Scraping TikTok
A consumer-insights team runni ...
Xyla Huxley
2026-10-13