


Web Scraper API
Fetch real-time data from 100+ websites,No development or maintenance required.
SCRAPING SOLUTIONS
Get accurate and in real-time results sourced from Google, Bing, and more.
With 120+ prebuilt and custom scrapers ready for any use case.
No blocks, no CAPTCHAs—unlock websites seamlessly at scale.
Execute scripts in stealth browsers with full rendering and automation
PROXY INFRASTRUCTURE
Over 100 million real residential IPs from genuine users across 190+ countries.
Reliable mobile data extraction, powered by real 4G/5G mobile IPs.
For time-sensitive tasks, utilize residential IPs with unlimited bandwidth.
Fast and cost-efficient IPs optimized for large-scale scraping.
SCRAPING SOLUTIONS
PROXY INFRASTRUCTURE
DATA FEEDS
Full details on all features, parameters, and integrations, with code samples in every major language.
LEARNING HUB
ALL LOCATIONS Proxy Locations
TOOLS
RESELLER
Get up to 50%
Contact sales:partner@thordata.com
Products $/GB
Fetch real-time data from 100+ websites,No development or maintenance required.
Get real-time results from search engines. Only pay for successful responses.
Execute scripts in stealth browsers with full rendering and automation.
Bid farewell to CAPTCHAs and anti-scraping, scrape public sites effortlessly.
Dataset Marketplace Pre-collected data from 100+ domains.
Over 100 million real residential IPs from genuine users across 190+ countries.
Reliable mobile data extraction, powered by real 4G/5G mobile IPs.
For time-sensitive tasks, utilize residential IPs with unlimited bandwidth.
Fast and cost-efficient IPs optimized for large-scale scraping.

Data for AI $/GB
Pricing $0/GB
Docs $/GB
Full details on all features, parameters, and integrations, with code samples in every major language.
Resource $/GB
EN $/GB
产品 $/GB
AI数据 $/GB
定价 $0/GB
产品文档 $/GB
资源 $/GB
简体中文 $/GB
勞動市場情報是一門資料算術的生意——每美元採到最多職缺的團隊,贏得產品展示。本文針對每月 200 萬筆職缺的工作負載,用三種方式實際計價:原始住宅代理、按結果計費的爬蟲 API、以及混合架構。過程中對 Thordata 與 Bright Data 做一場公平比較——因為這正是當時桌上那兩份報價。
勞動市場分析產品——薪資基準、招聘訊號 feed、技能需求指數——都在做同一個承諾:更多職缺、更新鮮、更便宜。贏得展示的是覆蓋率圖表漂亮的那一家。所以當一個招聘數據分析團隊決定重建採集層時,他們先把它變成一道算術題,然後才動基礎設施。
成本模型的好壞取決於工作負載規格。以下是他們用的版本:
| 參數 | 數值 |
|---|---|
| 每月目標職缺數 | 2,000,000 |
| 資料來源 | 主要求職網站、企業職缺頁、聚合器 |
| 平均職缺頁重量(HTML + 資源) | 約 350 KB |
| 更新策略 | 熱門網站每日、企業職缺頁每週 |
| 解析與去重負擔 | 約 30% 的抓取是內容變更後的重抓 |
規格直接推出兩個結論。第一,原始量:200 萬筆職缺加更新負擔,每月約 260 萬次頁面抓取,若以完整頁面抓取約 900 GB 流量。第二,目標來源中很大一部分是結構化的求職網站——正是現成爬蟲為之而生的那種標準化目標。記住第二點,模型有意思的地方就在這。
經典架構:住宅代理流量加上自建解析器。用兩家供應商的公開費率計價:
| Thordata | Bright Data | |
|---|---|---|
| 公開入門費率 | 1 GB 時 $2.00/GB | 按用量支付 $8.00/GB |
| 約 1 TB/月用量時的費率 | 滑桿 1 TB 點位 $0.73/GB | 方案區間 $5.00–6.00/GB($999–$1,999/月方案);1 TB 以上客製 |
| 900 GB/月,公開牌價 | 約 $650–900 | 約 $4,500–5,400 |
| 最低承諾 | 1 GB | 方案自 $499/月(141 GB)起;另有 PAYG |
以公開牌價計,同樣的 900 GB 在 Bright Data 列價上比 Thordata 滑桿貴約 5–7 倍。公平地說這個溢價買到什麼:Bright Data 是業界最完整的企業級網路資料平台之一——龐大的 IP 網路、成熟的解鎖產品線、企業合規工具,以及最高 $500 的首次儲值加碼——而且大買家能議到低於牌價。如果你的組織需要企業協議與成熟的企業供應商姿態,這些是實實在在的考量。但對一個比較公開牌價的自助式分析團隊而言,這個用量下的價差就是頭條數字。
不過路線 A 有一個比每 GB 費率更深的問題,而且兩家都適用:職缺頁是重量級頁面,按 GB 計費懲罰的是重量,不是價值。 你付錢下載導覽列、頁尾、追蹤腳本。這帶出了團隊的下一個問題。
Thordata 的 Web Scraper API 按交付結果計費——入門量約 每 1,000 筆 $1.00、量價約 $0.50——目錄超過 120 個現成爬蟲,涵蓋主要求職網站,驗證碼破解與 JavaScript 渲染內建。同一份工作負載重新計價:
| 指標 | 數值 |
|---|---|
| 所需職缺數 | 每月 2,000,000 筆 |
| 入門費率成本($1.00/千筆) | $2,000/月 |
| 量價成本(約 $0.50/千筆) | 約 $1,000/月 |
| 流量疑慮(被封頁面、重試、驗證碼) | 上游處理;失敗嘗試零成本 |
與路線 A 的比較不是接近,是懸殊。900 GB 下,Thordata 的住宅滑桿就已經勝過按結果計費的入門費率——但量價下的按結果模式(整份工作負載約 $1,000)勝過兩者,因為它計價的是交付物而不是下載量。而且維運面也縮小了:網站改版不必修解析器、不必寫驗證碼邏輯、不必編重試預算。
Bright Data 對等的自助式爬蟲產品透過其平台方案計價;對已在該生態系的團隊是正當路徑,但針對這個特定工作負載,公開的 PAYG 經濟學在規模上偏袒按結果計費。
團隊的最終架構:主要網站走按結果爬蟲,企業職缺頁的長尾保留一層原始住宅代理——小型網站、版面千奇百怪、沒有現成爬蟲涵蓋:
| 層 | 工作負載 | 計價 | 每月成本 |
|---|---|---|---|
| 現成爬蟲 | 主要網站的 160 萬筆職缺 | 約 $0.50/千筆 | 約 $800 |
| 住宅代理 | 職缺頁約 150 GB | 滑桿,約 $1.00/GB 區間 | 約 $150 |
| 職缺頁解析器維護 | 約 40 個網站模板 | 工程時間 | 遞減中 |
採集總成本:200 萬筆職缺約每月 $950——每筆職缺約 $0.0005。「1,000 美元能買幾筆職缺」的答案,對這份工作負載而言,是兩百萬筆。
團隊的產品路線圖上有一個客戶一直要的功能:哪些公司「看起來」正在招聘——搜尋結果裡跑著的職缺廣告、雇主品牌關鍵字、職缺頁的搜尋能見度上升。這個訊號住在 SERP 裡,不住在職缺頁裡。
加上它是第三層計價:Thordata 的 SERP API 量價約 每 1,000 次結構化回應 $0.70,或排程追蹤用的完整受管 SERP 監控解決方案。每天監看前 50,000 個雇主關鍵字,大約每月 $1,000,疊在職缺管線之上——而持續 SERP 資料爬取服務交付的就是結構化資料,零解析工程直接進入與職缺資料相同的資料倉儲。
企業職缺頁為什麼不用更便宜的資料中心代理? 職缺頁是小型網站,只有最粗糙的頻率限制,而資料中心 IP 段是小站第一個封的東西。住宅級流量裡被擋的職缺頁代價是一次重試;資料中心流量裡的代價是覆蓋率圖表上少一家公司。長尾的住宅層是為了「每美元的可靠度」,不是每 GB 的原始單價。
更新過程中消失的職缺怎麼辦? 按結果計費的漂亮之處:回傳「已下架」的過期職缺是便宜的訊號而不是浪費的流量——在勞動分析裡,墓碑本身就是資料點(職位被填滿了),而成本模型天然處理它。
200 萬筆對中型市場產品不是太多了嗎? 覆蓋率就是產品。覆蓋 40% 的展示圖表,輸給覆蓋 85% 的那一張;而按結果計費正是讓 85% 變得可負擔的原因——新增一個網站的邊際成本是它的職缺量乘以 $0.0005,事先已知。
直接買職缺資料集不是更簡單? 現成資料集(Thordata 的涵蓋 100 多個網域,約每 1,000 筆 $0.25)非常適合歷史回補與模型訓練,而即時採集服務新鮮度敏感的產品。多數成熟團隊兩者都跑:資料集打底,採集吃增量。
既有按 GB 架構的遷移路徑是什麼? 先把一小片流量鏡像到按結果 API——免費試用額度就夠——在你自己的來源上比較每美元的交付職缺數。本文的團隊在覆蓋率不變的情況下,把採集成本砍了約 60%,而 SERP 監控層沿用同一套「先試再承諾」的模式。
可以推廣的教訓是:在資料算術的生意裡,計價模式本身就是架構決策。按 GB 計費為你能控制的流量最佳化;按結果計費為你交付的資料最佳化。勞動市場情報交付的是職缺——所以按職缺計價的團隊贏得覆蓋率圖表,而 1,000 美元買到兩百萬筆。
 Looking for
Top-Tier Residential Proxies?您在寻找顶级高质量的住宅代理吗?
Proxy Rotation Strategy for Web Scraping: When to Rotate IPs and When to Keep a Session
Build a practical proxy rotati ...
Jenny Avery
2026-09-24
How to Scrape Amazon Product Data for Price and Availability Monitoring
Learn how to build an Amazon p ...
Jenny Avery
2026-09-24
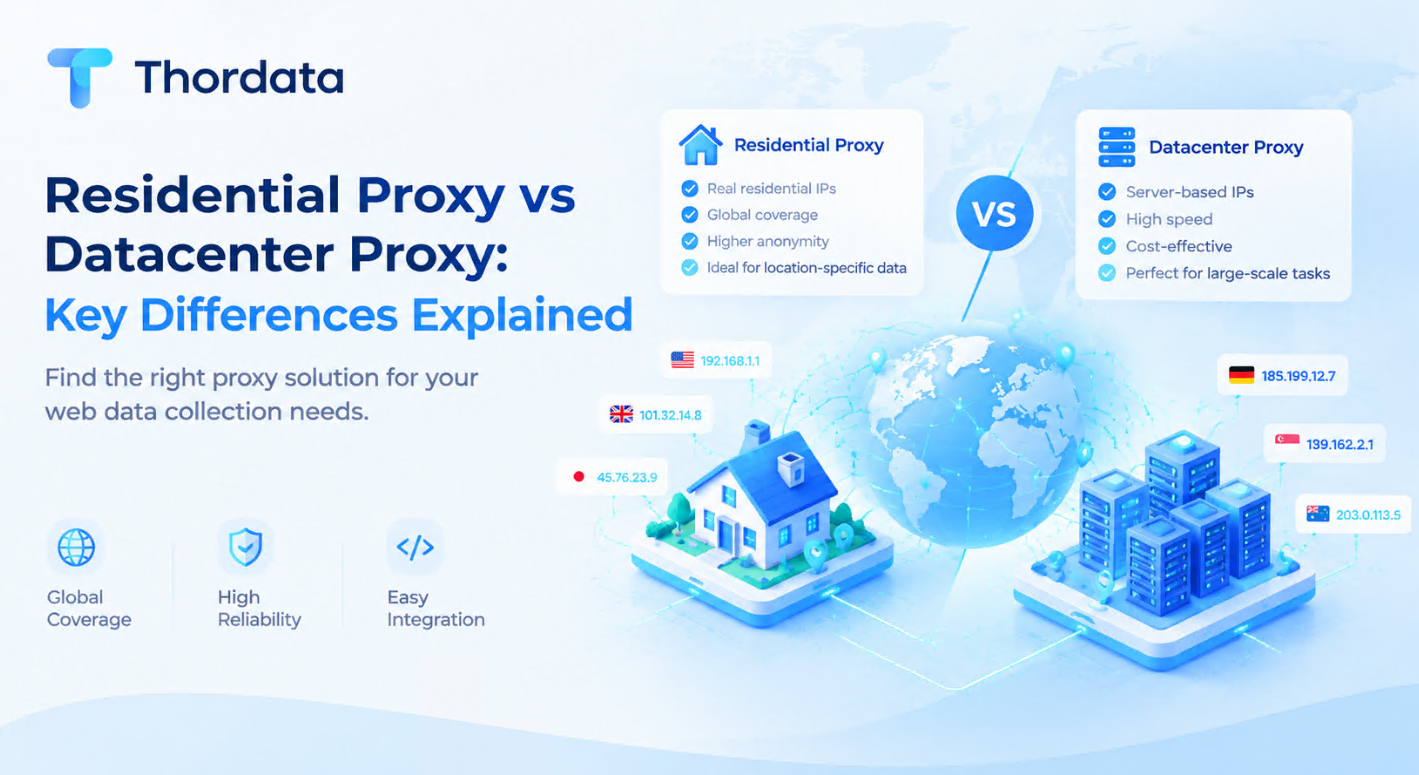
Residential Proxy vs Datacenter Proxy: Key Differences Explained
Learn the differences between ...
flora
2026-09-23
同一份工作負載,三種公司規模:Decodo 與 Thordata 的分階段計價
「哪個抓取平台更便宜」是錯的問題,因為答案隨成長而變。
Xyla Huxley
2026-09-22
行動 IP 是另一種產品:4G/5G、住宅與資料中心的訊號報告
買代理的人把「住宅」與「行動」當成同一種東西的兩個價格帶。
Xyla Huxley
2026-09-22
直接抄走這份設計文件:不會過時的影片推薦訓練資料
多數影片推薦系統的衰退,不是模型錯了,而是訓練資料凍住了—— ...
Xyla Huxley
2026-09-22
為什麼你的商品 Feed 永遠對不上供應商的:一份現場診斷
目錄錯配——同一個商品以三筆不同紀錄存在於你的 Feed、供 ...
Xyla Huxley
2026-09-22
90 秒完售:搶購監控團隊在倒數開始前就做錯的事
限量發售——球鞋、主機補貨、演唱會門票——是電商裡最惡劣的資 ...
Xyla Huxley
2026-09-22
Same Workload, Three Sizes of Company: Decodo and Thordata Priced at Every Stage
"Which scraping platform is ch ...
Xyla Huxley
2026-09-21